Probé AgentKit y gstack con la misma tarea: por qué uno cuesta 4× más (y no es el modelo)
AgentKit ($99) vs gstack (gratis, Garry Tan). Misma tarea, mismo commit. El ganador no fue el más caro: gstack resolvió igual, en menos tiempo y a un cuarto de coste. La causa: las skills.
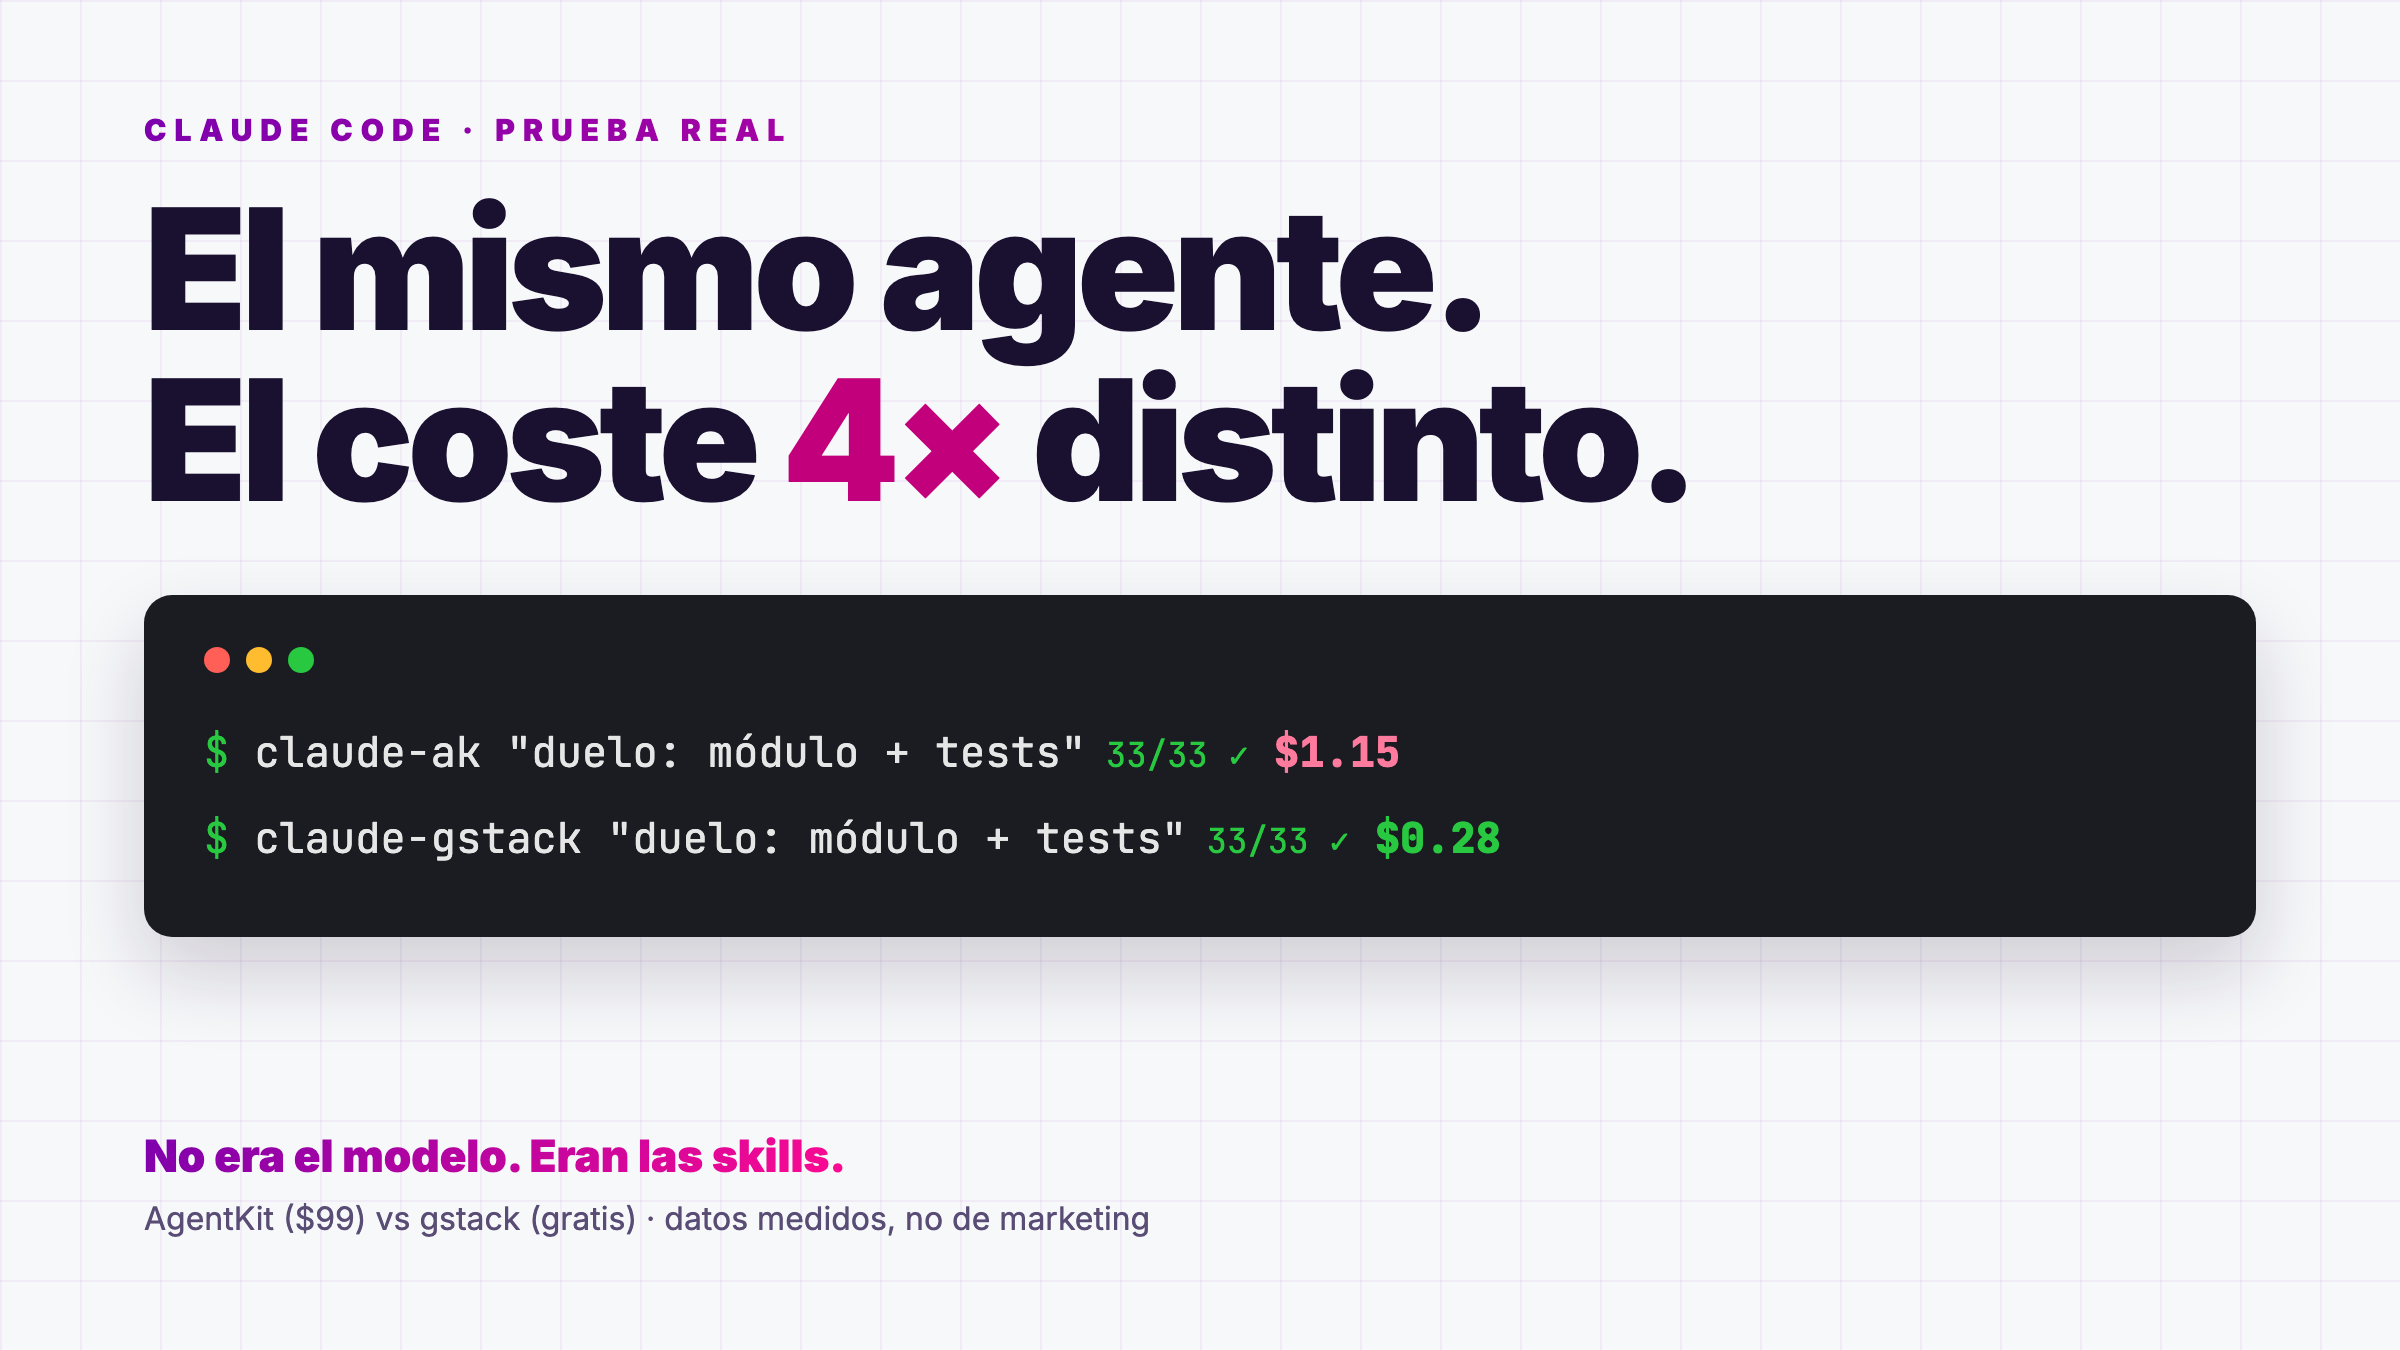
Tengo dos "kits" instalados para Claude Code: uno me costó 99 € y el otro es gratis. Hice que ambos hicieran exactamente lo mismo —mismo código, misma tarea, mismo commit base, en paralelo— para ver qué diferencia real hay. La respuesta no es lo que esperabas.
¿Qué son?
AgentKit (de pago)
AgentKit es un kit de 143 skills + 16 agentes especializados + hooks de seguridad que se instala en tu Claude Code. Es un "equipo de desarrollo virtual": un planificador, un code-reviewer, un tester, un git-manager... Cada skill es un fichero de instrucciones que Claude carga en contexto cuando el trabajo lo pide. Se vende a 99 € por pago único (el bundle con marketing, 149 €).
gstack (gratis)
gstack es el setup de Garry Tan (CEO de Y Combinator) para el flujo de trabajo que él usa con Claude Code. Open source, 135.800 estrellas, 58 skills con comandos tipo /office-hours, /review, /qa, /ship. Cero euros.
Unos 143 ficheros de instrucciones. Otros 58. ¿Afecta eso al precio por token? Resulta que sí, y bastante.
El duelo
La tarea: implementar un módulo commit-digest (parser de commits convencionales → changelog semanal en español) con 33 tests. Reglas: mismo spec, mismo commit base (98655ce4), misma máquina, mismo modelo (Opus 5.5 con mi suscripción Claude Max), cada uno en su entorno aislado, corriendo a la vez.
# Los dos worktrees, mismo commit
git worktree add /tmp/duelo-agentkit -b duelo-agentkit
git worktree add /tmp/duelo-gstack   -b duelo-gstack

# Misma orden a cada uno, en paralelo
claude-ak     -p "$(cat prompt.txt)" --output-format json > resultado-ak.json
claude-gstack -p "$(cat prompt.txt)" --output-format json > resultado-gstack.json
Resultado, medido con el propio --output-format json de Claude Code (no mis estimaciones):
| AgentKit | gstack | |
|---|---|---|
| Tiempo total | 59,0 s | 49,6 s |
| Tests pasando (verifiqué yo) | 33/33 | 33/33 |
| Errores TypeScript | 0 | 0 |
| Iteraciones | 0 (a la primera) | 0 (a la primera) |
| Cache read (tokens leídos) | 1.196.867 | 416.813 |
| Coste | $1,15 | $0,28 |
Cualidad: empate técnico. Ambos escribieron el módulo y los tests a la primera pasada, sin errores de tipos, con los 33 tests pasando. Ni uno se pasó por la cornada las reglas del spec.
Entonces, ¿por qué 4× de diferencia?
Mira la fila de cache read: AgentKit leyó 2,8× más tokens que gstack. ¿Sobre qué código? Ninguno —el módulo generado por ambos es prácticamente igual (126 vs 117 líneas). La diferencia está en lo que cada entorno carga en contexto por cada iteración:
- AgentKit carga su catálogo de 143 skills + 16 agentes + hooks de comportamiento en cada turno.
- gstack carga 58 skills.
Eso significa que el sobrecoste no viene del modelo ni del trabajo, sino del contexto que cada kit arrastra. Cada skill en el prompt es memoria de trabajo: se cobra como token leído en cada iteración, aunque el agente no la use en esa tarea. El trabajo era idéntico; la "maleta" era distinta.
El módulo que gstack generó (código real, sin retoques):
// commit-digest.ts — parser de commits convencionales → changelog
const HEADER_REGEX = /^([a-z]+)(?:\(([^()]+)\))?(!)?: (.*)$/

export function parseConventionalMessage(message: string) {
  const firstLine = message.split(/\r?\n/, 1)[0] ?? ''
  const match = HEADER_REGEX.exec(firstLine)
  if (!match) return null

  const [, type, scope, bang, rawDescription] = match
  if (!type || !isCommitType(type)) return null

  return {
    message,
    type,
    breaking: bang === '!' || BREAKING_CHANGE.test(message),
    description: (rawDescription ?? '').trim(),
    ...(scope ? { scope } : {}),
  }
}
¿Cuál uso entonces?
Los dos, según el trabajo. AgentKit para tareas multi-dominio donde sus 16 agentes y el routing de tareas se amortizan (ahí la "maleta" pesa, pero el contenido de la maleta te lo ahorra trabajo). gstack para flujos de feature concretos donde 58 skills enfocadas son más que suficientes —y cada token que no cargas, lo pagas menos.
Y una lección que aplica a cualquier setup de agentes: cuantas más skills cargues en contexto, más pagas por token leído, con o sin suscripción. Revisa tu catálogo de vez en cuando.
Si quieres aprender a montar tus propios setups de agentes sobre Claude Code, con tests y datos medidos como estos, ese es el tipo de contenido que hacemos en Codeia.dev.
Sobre el autor
Paulo Formador IA - Desarrollo y automatizaciones Fullstack: PHP, React, NextJS, Angular, Vue, Nuxt
