Shopify reconstruyó 300 pantallas de su app con IA. El truco no son los agentes: son 4 gates que no dejan shippar código roto
Shopify está reconstruyendo su app de 300 pantallas con IA. El truco no son los agentes: son 4 gates estrictos que no dejan commitear código sin probar. Te enseño a montar el gate 1 con un hook de Claude Code real.
Shopify reconstruyó 300 pantallas de su app con IA. El truco no son los agentes: son 4 gates que no dejan shippar código roto
Shopify está migrando su app de React Native a Swift y Kotlin nativo, y lo está haciendo con LLMs. Lo confirman ellos mismos en su blog de ingeniería: ya reconstruyeron la app Shop en 12 semanas, y ahora están a por la app principal, con más de 300 pantallas. Lo que nadie te cuenta es el porqué de que no salga un montón de código roto.
La respuesta es una herramienta interna llamada Helix. Y su idea central es simple de explicar y difícil de hacer bien: el primer intento de la IA no es correcto, así que le pones barreras (gates) que no le dejan avanzar hasta que lo sea. Esto no es un prompt mágico. Es un sistema — y es exactamente el tipo de pipeline agéntico que en Codeia montamos con checkpoints y rastro auditable.
Checkpoints pequeños, gates estrictos
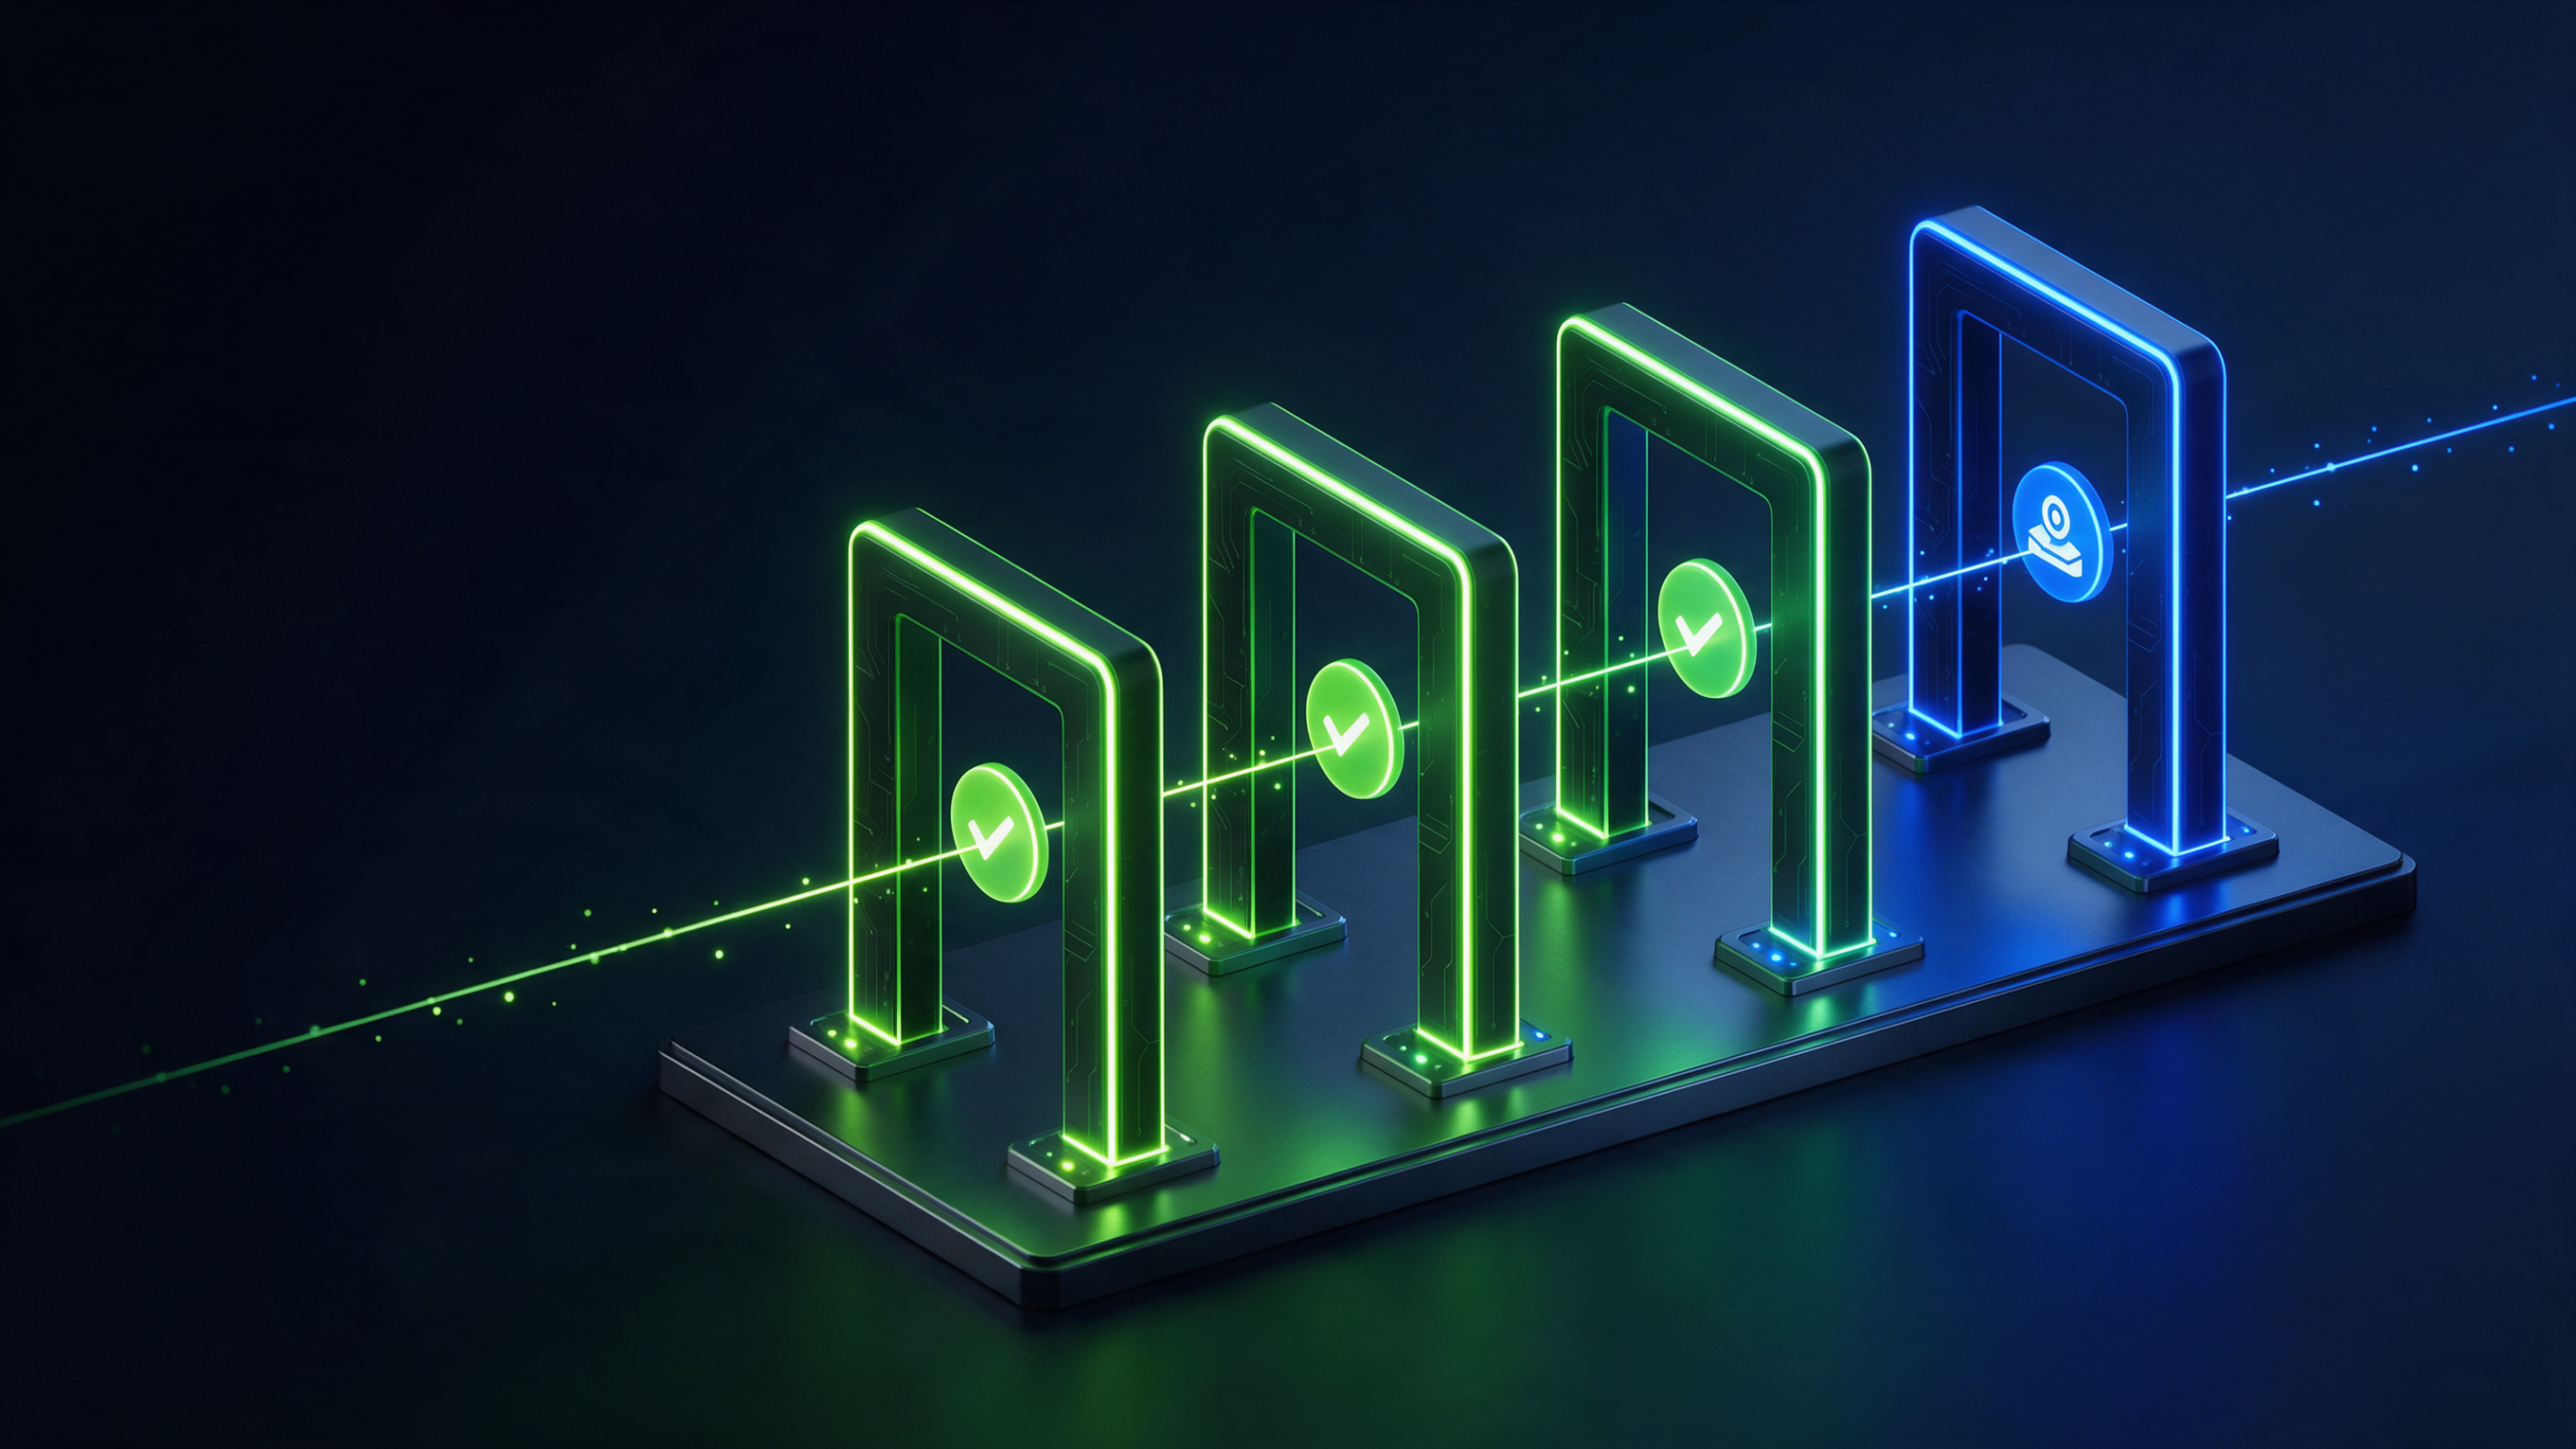
Helix no pide a la IA "convierte esta app entera". La rompe en checkpoints — trozos de trabajo tan pequeños que un ingeniero puede revisarlos en minutos. Y cada checkpoint no se commitea hasta pasar cuatro gates:
- Behavior — que demuestre lo que hace con tests que se escriben antes que el código.
- UI — que se parezca visualmente a la app de referencia.
- Adversarial review — que un agente asuma que el código está roto y pruebe a romperlo, dos veces.
- Humano — que un ingeniero lo apruebe.
Y lo que lo hace un sistema y no una lista de reglas: el feedback de cada gate se recuerda. Con cada checkpoint que sale bien, el loop se vuelve un poco más autónomo. Eso es lo que la IA no puede hacer sola: aprender de sus errores y reutilizarlos.
Gate 1 con código real: un hook, no una regla
La frase clave de este sistema es esta: "la diferencia entre una regla que el agente puede olvidar y un gate del que no puede salirse hablando." En Claude Code eso se implementa con un hook. Un hook es una regla dura: no la pide la IA, se ejecuta el motor antes de que el agente toque una herramienta. Aquí tienes el gate 1 real — el agente no puede hacer git commit si las tests no pasan:
{
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Bash(git commit*)",
        "hooks": [
          {
            "type": "command",
            "command": "npm test || \
echo '{\"decision\":\"block\",\"reason\":\"Gate 1 fallado: las tests no pasan. El checkpoint no puede commitear.\"}'"
          }
        ]
      }
    ]
  }
}
No es que la IA "se acuerde de hacer las tests". Es que el commit se bloquea en el motor. Si la test falla, el bloque sale solo y el agente tiene que arreglar el código y volver a intentarlo. Esto es un gate, no una sugerencia.
Gate 3 con ejemplo: el agente que asume que tu código está roto
El gate adversarial es el más interesante. En vez de pedirle a un agente "revisa este código" (que devuelve un "se ve bien, no veo problemas"), le dices que demuestre que está roto. El prompt de la skill es corto:
Actúa como un code reviewer adversarial. Asume que este código
ESTÁ ROTO. Tu trabajo es demostrarlo. Caza:
- condiciones de borde no cubiertas
- races / estado compartido
- supuestos sobre datos que pueden ser null
- lo que pasa si un dependiente falla

No propongas soluciones. Lista cada fallo con el archivo y la línea exacta.
Y esto es lo que devuelve sobre un checkout real (resumen de la salida que genera):
GATE 3 — ADVERSARIAL REVIEW

Fallo 1 · checkout.ts:42
  Asume que cart.items no está vacío.
  Si el carrito se vacía, items[0].price lanza un TypeError.

Fallo 2 · payment.ts:88
  No gestiona el timeout del PSP. Un hang deja el
  pedido en "pending" para siempre.

Fallo 3 · cart.ts:17
  Race: dos tabs abren el mismo carrito. El segundo write
  sobreescribe el descuento que aplicó el primero.

→ 3 fallos. El fixer debe corregirlos antes de aprobar el gate.
Un fixer agent corrige, el adversarial vuelve a atacar, y así hasta que no puede encontrar más fallos. Ida y vuelta forzada, no una revisión de cortésía.
Por qué importa (y qué llevarte)
No es "la IA de Shopify es mejor que la tuya". Es que la diferencia entre un agente que shippe y uno que no no está en el modelo, está en el sistema que lo rodea: checkpoints que caben en un vistazo, gates que no se pueden saltar, y memoria del feedback. Eso es un pipeline agéntico.
Y la buena noticia es que no necesitas ser Shopify para montarlo. Con Claude Code, unos pocos skills y dos o tres hooks tienes el mismo esqueleto: un plan que se revisa antes de construir, tests antes que código, una adversarial que rompe, y un humano que aprueba. En Codeia montamos estos sistemas con rastro, checkpoints y resultados auditable — el patrón que Shopify usa internamente, en una escala que tú puedes montar en tu proyecto.
Si quieres ver el esqueleto completo (skills + hooks) funcionando sobre una app real, en la comunidad lo montamos junto a otros.
Fuente
Shopify Engineering — "Helix: The internal tool powering our Shopify app's native migration" (21-sep-2026), la fuente primaria que confirma los 4 gates, los checkpoints y la cifra de las 300 pantallas. La recreación en Claude Code (orquestador + hooks + skills) viene del vídeo de AI LABS, que montó el mismo sistema y lo testearon sobre una app interna. El hook de PreToolUse y el gate adversarial son el patrón estándar de Claude Code; aquí lo aplicamos al esqueleto de Helix.
Etiquetas
Sobre el autor
Paulo Formador IA - Desarrollo y automatizaciones Fullstack: PHP, React, NextJS, Angular, Vue, Nuxt